
LoraTag - 面向 LoRA 训练的 AI 图像描述生成工具 | 批量数据集准备工具
为这个工具评分
平均分
总投票数
选择你的评分(1-10):
详细信息
是什么
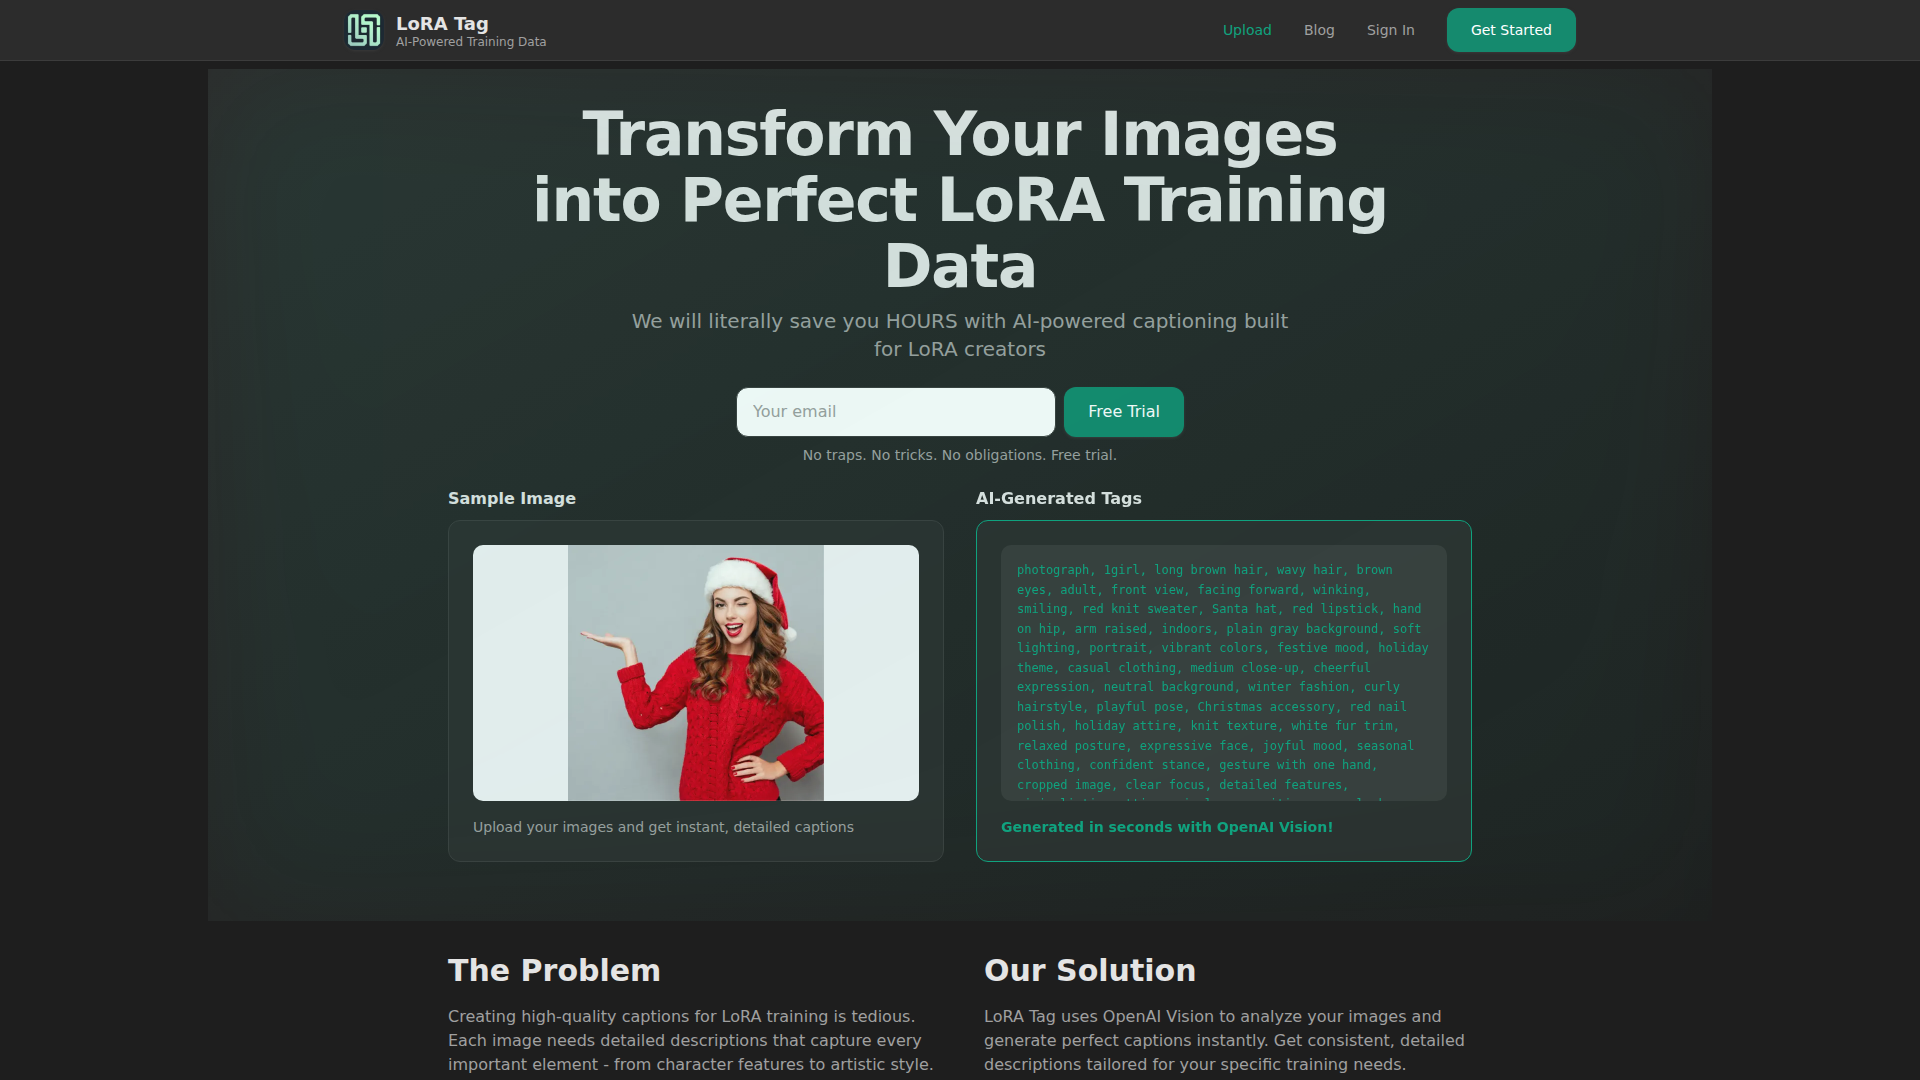
LoraTag 是一款基于 Web 的图像描述生成工具,用于准备 LoRA 训练数据集。它根据页面不同区域使用 GPT-4 Vision 或 OpenAI Vision,为图像生成自然语言描述,并导出与 LoRA 训练工作流配套使用的 .txt 文件。
它面向 AI 艺术家、LoRA 创作者以及从事 Stable Diffusion、SDXL、SD3 和 FLUX 相关训练流程的微调研究人员。其核心工作流程是上传图像、选择描述细节设置、批量生成描述、审核或编辑描述,并下载可直接用于训练的文件;其定位看起来是一个以浏览器为优先的数据集准备工具,专注于比手动编写或简单打标签器更快且更一致的描述生成。
功能
- 批量图像描述生成 — 一次处理多张图像,减少逐张手写描述的人工工作量。
- 多种描述细节级别 — 允许用户根据训练目标和 token 限制选择更短或更详细的输出。
- 自然语言描述生成 — 生成包含主体、构图、风格、光照、颜色和上下文的描述,而不仅仅是逗号分隔的标签。
- 可直接用于训练的
.txt导出 — 为每张图像输出一个描述文件,格式适用于 kohya_ss、EveryDream、SimpleTuner、ai-toolkit 等常见 LoRA 训练工具及相关工具。 - 浏览器内审核与编辑 — 允许用户在下载数据集前检查、优化或重新生成描述。
- 文件夹与数据集组织支持 — 支持文件夹并保留目录结构,有助于在导出时维护较大的训练数据集。
实用提示
- 仔细核对套餐和配额细节 — 源内容在不同部分显示的限制和定价不一致,因此购买前应在产品实时页面确认当前图像额度、质量等级和套餐功能。
- 使用已清理且构图一致的图像 — 当数据集本身已具备一致裁剪、主体聚焦和较少噪点时,生成的描述通常更适合训练。
- 使描述长度匹配训练目标 — 较短的描述可能更适合触发词工作流,而当构图、风格和关系很重要时,标准或详细描述会更合适。
- 导出前审核描述 — 即使视觉模型表现强,人工审核对于处理边缘情况、命名一致性和 token 预算控制仍然很重要。
- 确认数据处理要求 — 页面说明图像会在内存中处理、发送至 OpenAI 的 Vision API,随后删除,因此对隐私要求严格的团队应根据内部政策核实该流程。
OpenClaw 技能
LoraTag 很适合作为 OpenClaw 生态中的一部分,用于生成式 AI 团队的数据集准备工作流。一个可能的用例是:由 OpenClaw 技能监控某个文件夹或项目工作区,提交新的训练图像进行描述生成,检查 token 长度,并将生成的 .txt 文件路由到标准化的 LoRA 训练流水线中。如果某些套餐提供 API 访问,这类自动化会更具可行性,不过页面并未说明原生的 OpenClaw 集成。
更广泛的 OpenClaw 代理层也可以帮助创意团队大规模落实描述生成流程。可能的工作流包括:标记描述不一致问题的数据集 QA 代理、在角色或产品数据集中执行命名规则的风格治理代理,以及为 kohya_ss 或 SimpleTuner 等特定工具打包已生成描述图像的训练准备代理。对于 AI 艺术工作室、合成媒体团队和研究团队而言,这种组合可将描述生成从人工瓶颈转变为可重复执行的生产步骤,并在 LoRA 开发中获得更好的一致性。
嵌入代码
将下面的代码复制到你的网站或博客中,即可展示这个 AI 工具。嵌入的小组件会自动同步最新信息。
<iframe src="https://aimyflow.com/ai/loratag-ai/embed" width="100%" height="400" frameborder="0"></iframe>
探索相似工具
Versive
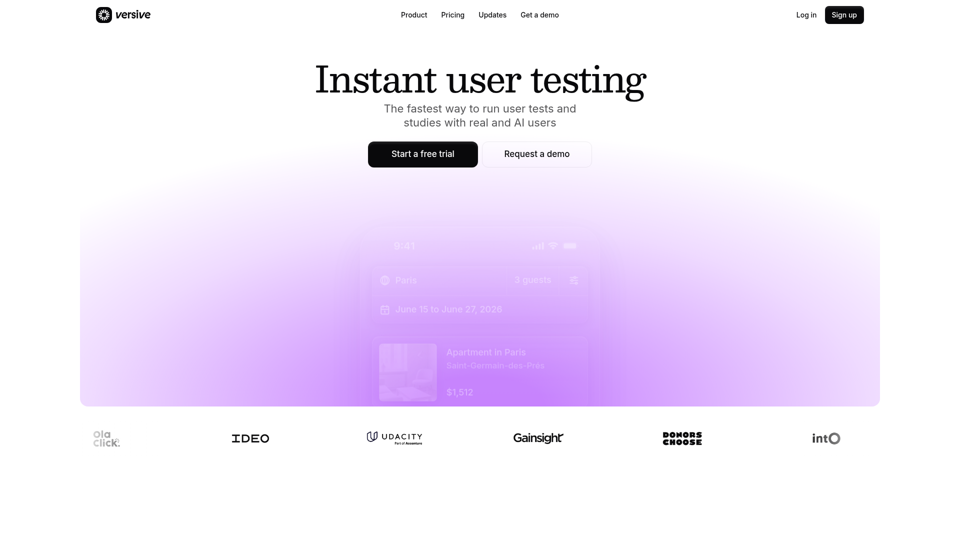
Versive 是一个由 AI 驱动的用户研究与测试平台,帮助产品团队与真实及模拟用户一起设计、执行并整合可用性研究,尤其适用于产品经理、UX 研究员和设计师。在 AI 辅助的产品开发中,它可以通过在几分钟内生成访谈记录、截图、摘要和可执行建议,帮助这些团队更快验证界面决策。
挑战 | 测试你的 AI 提示词编写技能
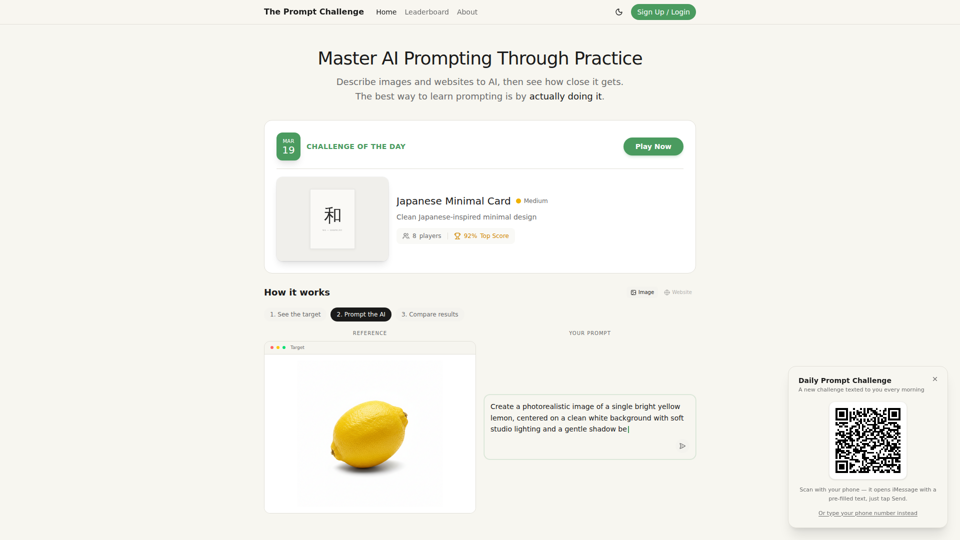
Prompt Challenge 是一个练习平台,通过描述图像和网站、将 AI 生成结果与参考内容进行比较,以及进行分数竞赛,帮助用户提升 AI 提示词编写能力,主要面向学习提示工程和进行 AI 实操创作的人群。对于设计师、开发者和 AI 从业者来说,这种可重复的提示词测试能够强化指令编写技能,并提升在使用生成式工具进行视觉和界面工作时的一致性。
AI 信息图生成器
GraphicInfo 是一款 AI 信息图生成器,帮助用户快速将想法和内容转化为专业、可定制的信息图,主要面向创作者以及制作网站或社交媒体内容的人群。在 AI 驱动的内容工作流程中,它可以帮助营销人员、内容团队和设计师加快视觉素材创作,同时仍可根据特定品牌需求优化文本和图像。
图像去模糊 — 使用 AI 让模糊照片更清晰
Unblur Image 是一款由 AI 驱动的在线照片去模糊工具,帮助用户修复运动模糊、锐化失焦图像、修复老照片并提升文字清晰度,主要面向那些无需手动编辑技能也希望快速增强图像效果的人群。在 AI 时代的工作流程中,它可以帮助摄影师、内容团队以及需要频繁处理文档的专业人士,更快地从不完美的源图像中恢复可用的视觉素材和可读内容。
IconBrain|适用于应用和品牌的 AI 图标生成器
IconBrain 是一款 AI 图标、横幅和品牌资产生成器,帮助用户通过文本提示或品牌上下文创建和编辑可直接用于生产的视觉素材,主要面向正在发布应用或品牌的开发者和创作者。用于产品、营销和设计工作时,它可以加快早期品牌资产的创建,同时帮助团队在各个平台上保持更一致的视觉风格。
免费图片提示词生成器 - image2prompt.net
image2prompt.net 是一款免费的 AI 图像转提示词生成器,可分析上传的图片或图片 URL,并将其转换为适用于 Midjourney、Stable Diffusion、Flux 及类似模型的可编辑提示词,主要面向 AI 艺术家、设计师和创作者。对于创意专业人士而言,它可以加快提示词起草,支持风格一致性,并减少在不同图像生成工作流中手动重写提示词的工作量。
UXCanvas.ai | AI UI/UX 设计代理——描述即可,设计即成
UXCanvas.ai 是一款 AI UI/UX 设计代理,可帮助用户将文本提示转化为可用于生产的界面设计,通过聊天进行迭代,并导出到 Figma 或 React 代码,主要面向设计师和开发者。对于 UI/UX 和产品团队,它可以通过将粗略想法转化为结构化规范、可复用组件和可直接用于代码的资源,缩短从概念到交付的路径。
AI 高清动漫:动漫图像放大的终极之选
AI HD Anime 是一款免费的在线 AI 图像放大工具,可提升动漫和漫画图像的清晰度并恢复细节,主要面向动漫爱好者。在 AI 辅助的创作与归档工作流程中,它可以帮助插画师、编辑和社区策展人快速改善低分辨率的动漫视觉内容,以用于审阅、分享或保存。