
专业级精准 AI 图像生成 | Diffus
为这个工具评分
平均分
总投票数
选择你的评分(1-10):
详细信息
是什么
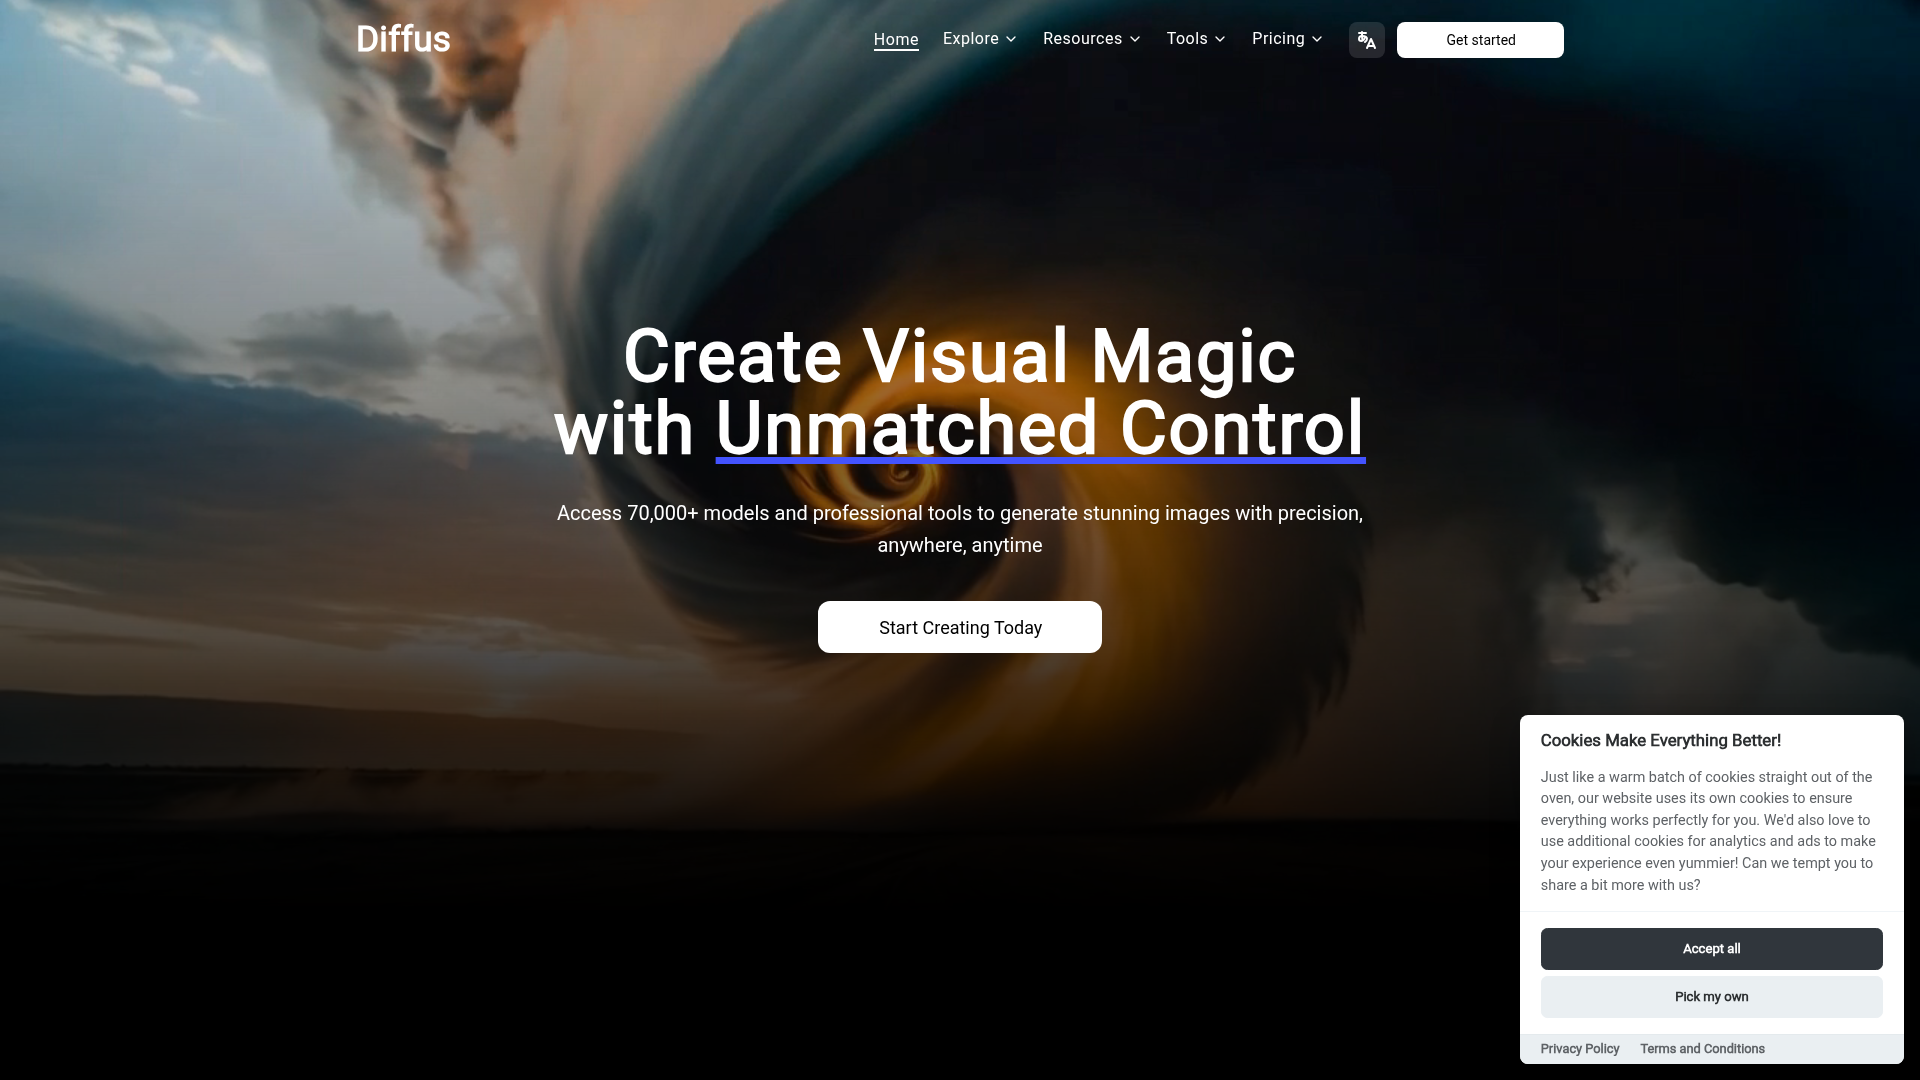
Diffus 是一个基于浏览器的 AI 图像生成平台,专注于专业级控制能力和模型灵活性。根据页面信息,它提供对大型图像生成模型库的访问,以及用于以比基础仅提示词生成器更高精度创建和编辑图像的工具。
它似乎适合设计师、AI 艺术家以及其他希望在无需管理本地 GPU 硬件的情况下使用高级图像工作流的用户。其定位很可能是一个面向专业级图像生成、模型实验和可控编辑的 Web 平台,网站导航中还列出了与图像编辑和 AI 视频相关的工具。
功能
- 大型模型库:提供对超过 70,000 个模型的访问,包括 checkpoints 和 LoRA,支持广泛的视觉风格与实验。
- 高级图像控制:包含 Inpaint 和 ControlNet 等工具,可优化结构、构图和局部编辑。
- 人脸增强工具:提供 ADetailer 和人脸修复功能,以提升生成图像中的面部质量和表情表现。
- 自定义模型支持:允许用户上传并使用自己的模型,适用于专业化视觉输出和专有创意工作流。
- 基于浏览器生成:在浏览器中运行,减少用户在本地维护昂贵 GPU 硬件的需求。
- 相关创意工具:导航中显示了其他产品,如 AI 图像编辑器、AI 视频生成器和 ComfyUI 工具,表明其可能提供更广泛的生成式媒体工作空间。
实用建议
- 评估控制深度,而不仅仅是模型数量:对于专业图像工作流,修复绘制和 ControlNet 这类工具通常比单纯的模型数量更重要。
- 尽早验证自定义模型处理能力:如果你的团队依赖私有或微调模型,应在标准化采用该平台之前确认上传限制、支持格式和工作流步骤。
- 在真实项目中测试浏览器性能:基于浏览器的方案提升了可访问性,但实际是否适用取决于其对典型图像尺寸和编辑复杂度的响应表现。
- 为人脸和编辑建立质量控制流程:ADetailer 和修复功能很有用,但团队仍应制定审核标准,以确保输出一致性。
- 确认不同工具之间的产品边界:网站列出了多个生成器和编辑器,因此采购方应区分哪些能力属于核心图像生成器原生功能,哪些是单独工具或独立板块。
OpenClaw 技能
Diffus 很可能适合作为 OpenClaw 生态中的图像生成层,用于创意自动化工作流。可能的应用场景包括:由智能体将简报转化为提示词集合,将请求路由到特定模型类型,生成图像变体,然后通过修复绘制或构图控制触发修订流程。对于制作营销素材、概念艺术、产品视觉或社交媒体创意内容的团队,OpenClaw 技能可以为 Diffus 增加工序化结构,而不是仅依赖手动迭代提示词。
更强的组合工作流可以包括 OpenClaw 创意总监智能体、品牌风格约束技能、模型选择助手,以及用于检查人脸质量或构图问题的 QA 审核器。如果自定义模型是工作流的一部分,OpenClaw 还可能协调资产接收、标签管理和面向不同部门或客户的输出路由。这样的配置有望显著提升设计运营、创意代理机构和媒体团队的速度与一致性,不过源页面并未确认任何原生 OpenClaw 集成。
嵌入代码
将下面的代码复制到你的网站或博客中,即可展示这个 AI 工具。嵌入的小组件会自动同步最新信息。
<iframe src="https://aimyflow.com/ai/diffus-graviti-com/embed" width="100%" height="400" frameborder="0"></iframe>
探索相似工具
Versive
Versive 是一个由 AI 驱动的用户研究与测试平台,帮助产品团队与真实及模拟用户一起设计、执行并整合可用性研究,尤其适用于产品经理、UX 研究员和设计师。在 AI 辅助的产品开发中,它可以通过在几分钟内生成访谈记录、截图、摘要和可执行建议,帮助这些团队更快验证界面决策。
挑战 | 测试你的 AI 提示词编写技能
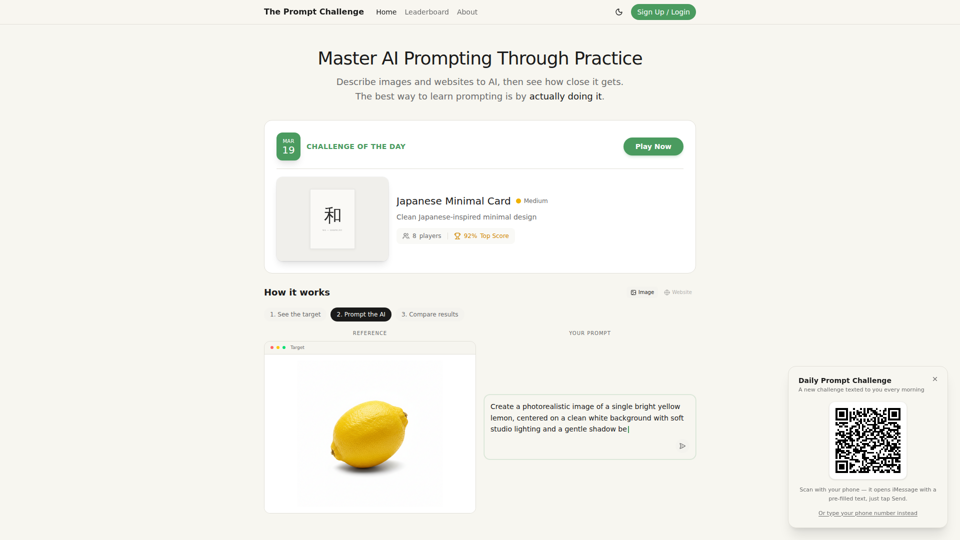
Prompt Challenge 是一个练习平台,通过描述图像和网站、将 AI 生成结果与参考内容进行比较,以及进行分数竞赛,帮助用户提升 AI 提示词编写能力,主要面向学习提示工程和进行 AI 实操创作的人群。对于设计师、开发者和 AI 从业者来说,这种可重复的提示词测试能够强化指令编写技能,并提升在使用生成式工具进行视觉和界面工作时的一致性。
AI 信息图生成器
GraphicInfo 是一款 AI 信息图生成器,帮助用户快速将想法和内容转化为专业、可定制的信息图,主要面向创作者以及制作网站或社交媒体内容的人群。在 AI 驱动的内容工作流程中,它可以帮助营销人员、内容团队和设计师加快视觉素材创作,同时仍可根据特定品牌需求优化文本和图像。
图像去模糊 — 使用 AI 让模糊照片更清晰
Unblur Image 是一款由 AI 驱动的在线照片去模糊工具,帮助用户修复运动模糊、锐化失焦图像、修复老照片并提升文字清晰度,主要面向那些无需手动编辑技能也希望快速增强图像效果的人群。在 AI 时代的工作流程中,它可以帮助摄影师、内容团队以及需要频繁处理文档的专业人士,更快地从不完美的源图像中恢复可用的视觉素材和可读内容。
IconBrain|适用于应用和品牌的 AI 图标生成器
IconBrain 是一款 AI 图标、横幅和品牌资产生成器,帮助用户通过文本提示或品牌上下文创建和编辑可直接用于生产的视觉素材,主要面向正在发布应用或品牌的开发者和创作者。用于产品、营销和设计工作时,它可以加快早期品牌资产的创建,同时帮助团队在各个平台上保持更一致的视觉风格。
免费图片提示词生成器 - image2prompt.net
image2prompt.net 是一款免费的 AI 图像转提示词生成器,可分析上传的图片或图片 URL,并将其转换为适用于 Midjourney、Stable Diffusion、Flux 及类似模型的可编辑提示词,主要面向 AI 艺术家、设计师和创作者。对于创意专业人士而言,它可以加快提示词起草,支持风格一致性,并减少在不同图像生成工作流中手动重写提示词的工作量。
UXCanvas.ai | AI UI/UX 设计代理——描述即可,设计即成
UXCanvas.ai 是一款 AI UI/UX 设计代理,可帮助用户将文本提示转化为可用于生产的界面设计,通过聊天进行迭代,并导出到 Figma 或 React 代码,主要面向设计师和开发者。对于 UI/UX 和产品团队,它可以通过将粗略想法转化为结构化规范、可复用组件和可直接用于代码的资源,缩短从概念到交付的路径。
AI 高清动漫:动漫图像放大的终极之选
AI HD Anime 是一款免费的在线 AI 图像放大工具,可提升动漫和漫画图像的清晰度并恢复细节,主要面向动漫爱好者。在 AI 辅助的创作与归档工作流程中,它可以帮助插画师、编辑和社区策展人快速改善低分辨率的动漫视觉内容,以用于审阅、分享或保存。