
LLaDA-Image – オンラインAI画像生成・編集ツール
このツールを評価
平均スコア
総投票数
スコアを選択(1〜10):
詳細情報
概要
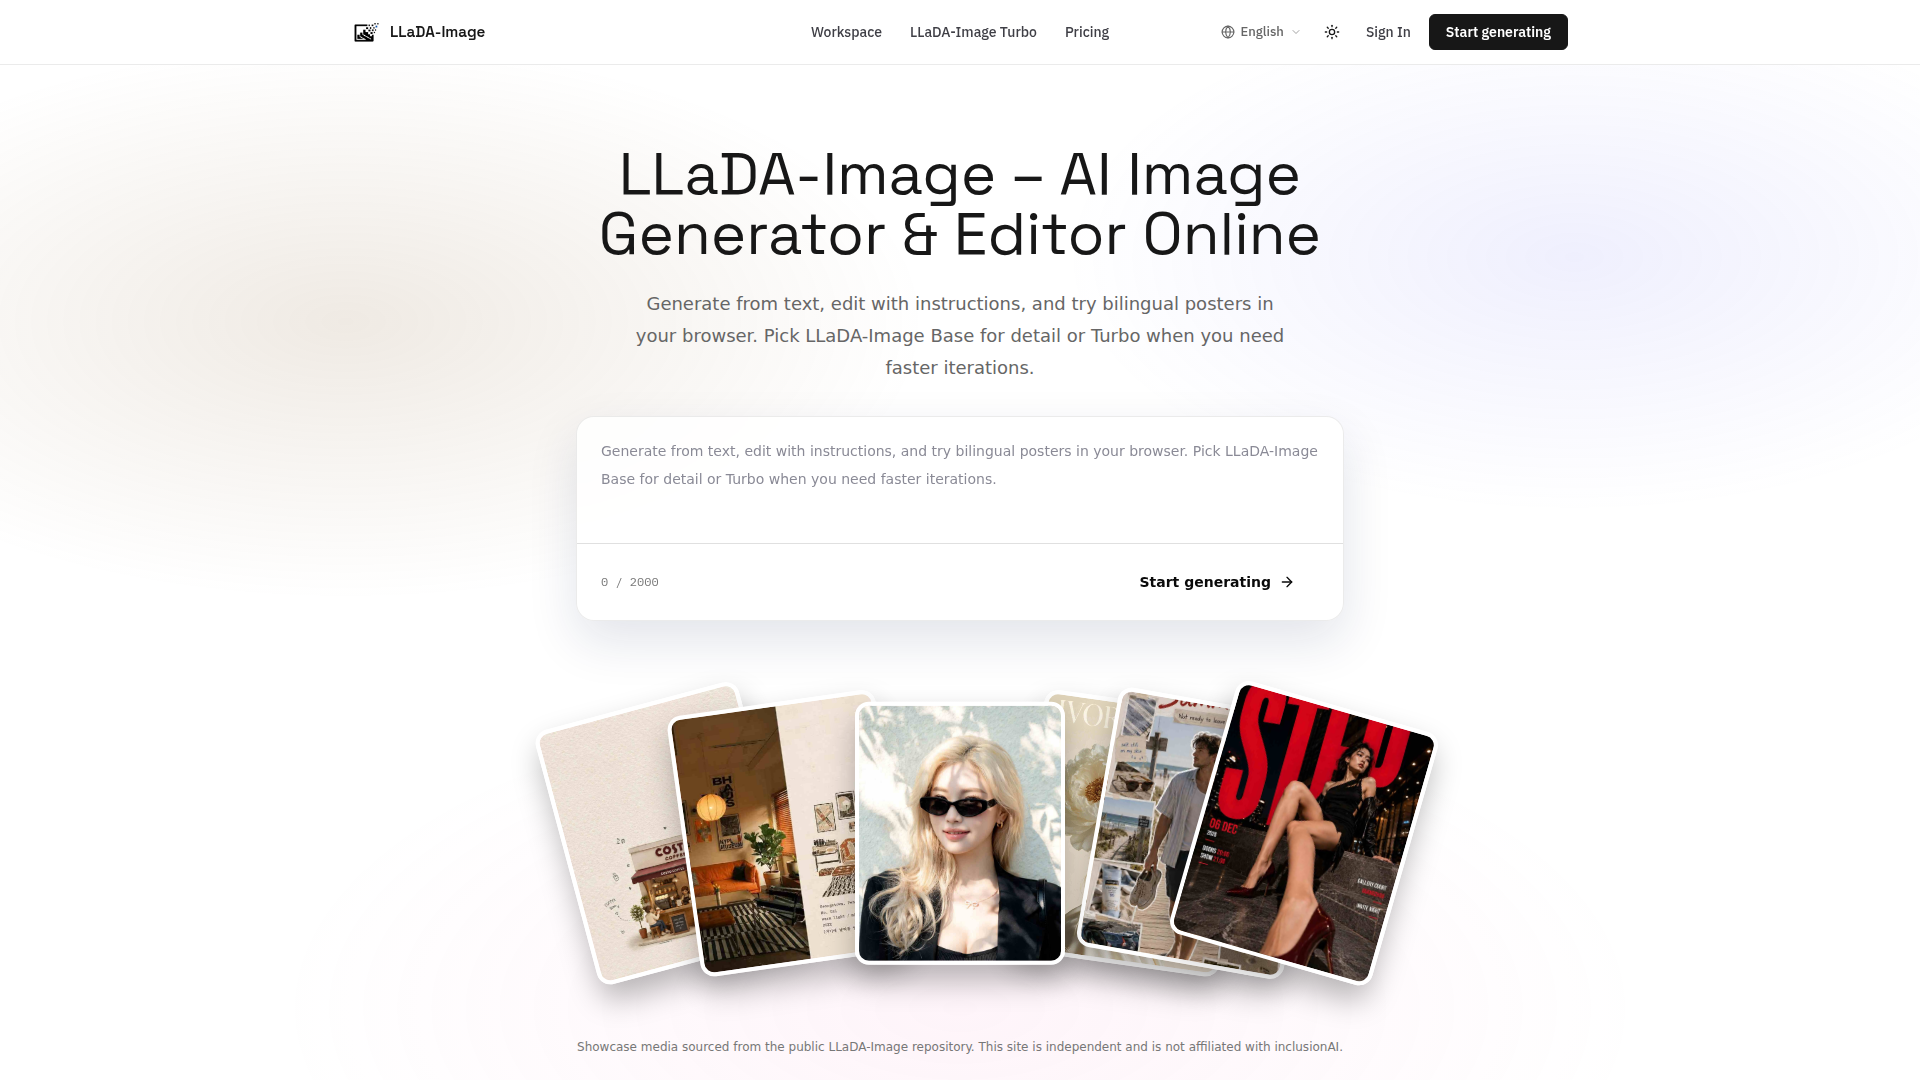
LLaDA-Imageは、inclusionAIが提供する画像生成・編集向けの6Bオープン統合拡散モデルファミリーをホスト環境で利用できる、独立したブラウザベースのワークスペースです。Text-to-Image、VQ条件付き生成、指示ベースの編集を単一のチェックポイントに統合することで、生成と編集で異なるモデルを管理するワークフローの煩雑さを解消します。本サービスは主に、ローカルインフラを管理することなく、高速なプロトタイピング、バイリンガルなビジュアルアセット生成、アイデンティティを保持した編集を必要とするクリエイターやデザイナー向けに設計されています。
主な機能
- 統合された生成・編集チェックポイント: 単一の6B拡散スタック内でText-to-Image生成と指示ベースの編集を統合し、別の編集用モデルを不要にします。
- 2種類の生成パス: 50サンプリングステップで動作する高忠実度のBaseモデルと、高速ドラフト向けに2〜4ステップで動作する蒸留版Twin-DMD Turboモデルを提供します。
- バイリンガルな画像内テキストレンダリング: 生成画像内に英語と中国語のタイポグラフィを高精度でレンダリング可能であり、ポスターやマーケティング用レイアウトの作成に適しています。
- 指示ベースの編集: アップロードされた参照画像の元となる被写体のアイデンティティを維持しながら、テキストコマンドに基づいて特定の視覚要素や背景を変更します。
- VQ条件付きプロンプティング: 初期の参照画像を必要とせず、テキストプロンプトから直接LLaDA2の画像VQトークンを利用したビジュアル生成を可能にします。
活用のヒント
- Turboでプロトタイプを作成してから最終化: 50ステップのBaseモデルに時間とクレジットを費やす前に、2〜4ステップのTurboモデルを使用してレイアウト、プロンプトの構成、構図をテストしてください。
- 画像解像度の厳密な設定: カスタム画像解像度は、標準のText-to-Image生成では16の倍数、指示ベースの編集パイプラインを実行する場合は32の倍数になるように設定してください。
- ワークスペースクレジットの消費差に注意: 標準生成やTurboモデルの実行は約10クレジットを消費するのに対し、Baseモデルでの指示編集には大幅に多いクレジット(約58クレジット以上)が必要となるため、クレジット消費を計画的に管理してください。
OpenClawスキル
提供されたドキュメントには、OpenClawとのネイティブ統合に関する言及はありません。想定されるユースケースとして、OpenClawの自律型マーケティングエージェントが基盤となるオープンなDiffusersパイプラインに接続し、キャンペーン制作をエンドツーエンドで実行することが考えられます。これには、Turboを用いたバイリンガル広告コンセプトの生成、レイアウト適合性の評価、背景調整のための自動指示編集の発行などが含まれます。このような実装により、プロンプトの作成、アセットの反復改善、最終レンダリングを自律エージェントのワークフロー内で調整し、手動によるグラフィック制作サイクルを短縮できます。
埋め込みコード
以下のコードをコピーしてサイトやブログに貼り付けると、この AI ツールを掲載できます。埋め込みウィジェットは最新情報に自動更新されます。
<iframe src="https://aimyflow.com/ai/lladaimage-com/embed" width="100%" height="400" frameborder="0"></iframe>
類似ツールを探す
Versive
Versive は、AI を活用したユーザーリサーチおよびテストプラットフォームで、プロダクトチームが実際のユーザーやシミュレーションされたユーザーを対象に、ユーザビリティ調査の設計、実施、統合を行えるよう支援します。特に、プロダクトマネージャー、UX リサーチャー、デザイナーに適しています。AI 支援によるプロダクト開発においては、議事録、スクリーンショット、要約、実行可能な提案を数分で生成することで、これらのチームがインターフェースに関する意思決定をより迅速に検証できるようにします。
チャレンジ | AIプロンプト作成スキルを試そう
Prompt Challenge は、画像やウェブサイトを説明し、AI が生成した結果を参照例と比較し、スコアを競うことで、ユーザーの AI プロンプト作成スキル向上を支援する練習プラットフォームであり、主にプロンプトエンジニアリングや実践的な AI 制作を学ぶ人々を対象としています。デザイナー、開発者、AI 実務者にとって、このような反復可能なプロンプトテストは、指示文作成スキルを磨き、ビジュアルやインターフェース制作で生成ツールを使用する際の一貫性向上に役立ちます。
AIインフォグラフィック生成ツール
GraphicInfo は、アイデアやコンテンツを迅速にプロフェッショナルでカスタマイズ可能なインフォグラフィックに変換できる AI インフォグラフィック生成ツールで、主にクリエイターやウェブサイト・SNS 向けコンテンツ制作者を支援します。AI 主導のコンテンツ制作ワークフローにおいては、マーケター、コンテンツチーム、デザイナーが、特定のブランドニーズに合わせてテキストや画像を調整しながら、ビジュアル素材の作成を効率化するのに役立ちます。
オンライン画像・写真翻訳 – 無料でお試し | Transmonkey
Transmonkeyは、元の背景を保持しながら130以上の言語で画像内のテキストを翻訳するAI画像翻訳ツールであり、クリエイター、マーケター、グローバル企業向けに設計されています。光学式文字認識(OCR)と大規模言語モデル(LLM)を組み合わせることで、手作業によるグラフィックの再デザインを必要とせず、ビジュアルのローカライゼーションを効率化します。
Nano Banana ウォーターマーク除去 — 無料・ローカル
Nano Banana Watermark Removerは、デジタルクリエイター向けにGoogle Geminiの画像から四隅の透かしマークを除去するブラウザベースのツールです。圧縮を行わずローカル環境でファイルを処理するため、デザイナーは制作ワークフローに向けてAI生成アセットを効率的かつクリーンに準備できます。
画像のぼかしを除去 — AIでぼやけた写真を鮮明にします
Unblur Image は、AI を活用したオンライン写真ぼかし補正ツールで、モーションブラーの修正、ピンぼけ画像のシャープ化、古い写真の復元、文字の鮮明化を支援します。主に、手動編集のスキルがなくても素早く画像を改善したいユーザー向けです。AI 時代のワークフローにおいては、写真家、コンテンツチーム、文書を多く扱う専門職が、不完全な元画像から実用的なビジュアルや判読可能な素材をより迅速に復元するのに役立ちます。
IconBrain | アプリとブランド向けのAIアイコンジェネレーター
IconBrainは、AIを活用したアイコン、バナー、ブランドアセットの生成ツールで、主にアプリやブランドを立ち上げる開発者やクリエイター向けに、テキストプロンプトやブランドコンテキストから本番利用可能なビジュアルの作成・編集を支援します。製品、マーケティング、デザイン業務において、初期のブランドアセット制作を迅速化しながら、チームがプラットフォーム間でより一貫したビジュアルスタイルを維持するのに役立ちます。
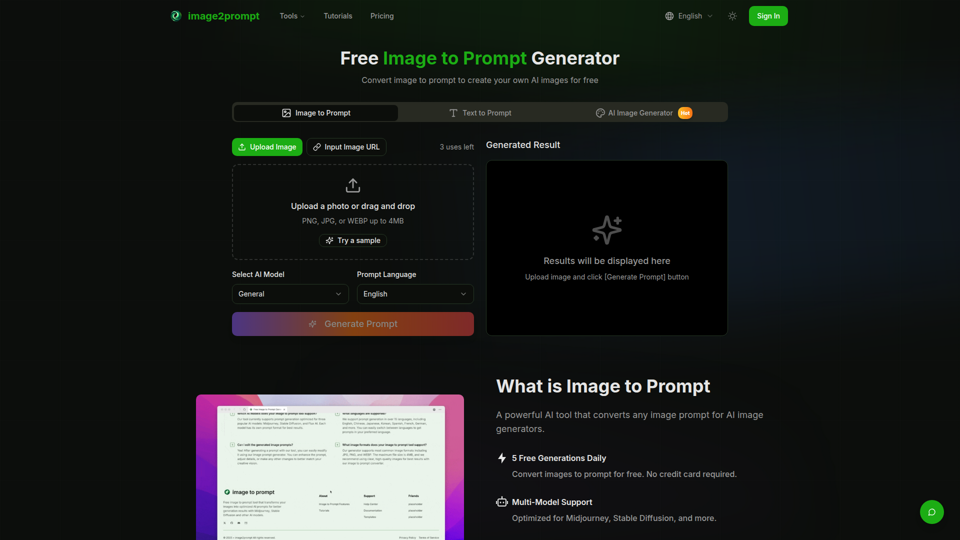
無料の画像からプロンプト生成ツール - image2prompt.net
image2prompt.net は、アップロードした画像や画像URLを解析し、Midjourney、Stable Diffusion、Flux などのモデル向けに編集可能なプロンプトへ変換する、無料のAI画像-to-プロンプト生成ツールです。主にAIアーティスト、デザイナー、クリエイター向けに設計されています。クリエイティブの現場では、プロンプト作成の高速化、スタイルの一貫性の維持、異なる画像生成ワークフロー間での手作業によるプロンプト書き換えの削減に役立ちます。