
Modelos de difusión de video
Valora esta herramienta
Puntuación media
Votos totales
Selecciona tu puntuación (1-10):
Información detallada
Qué
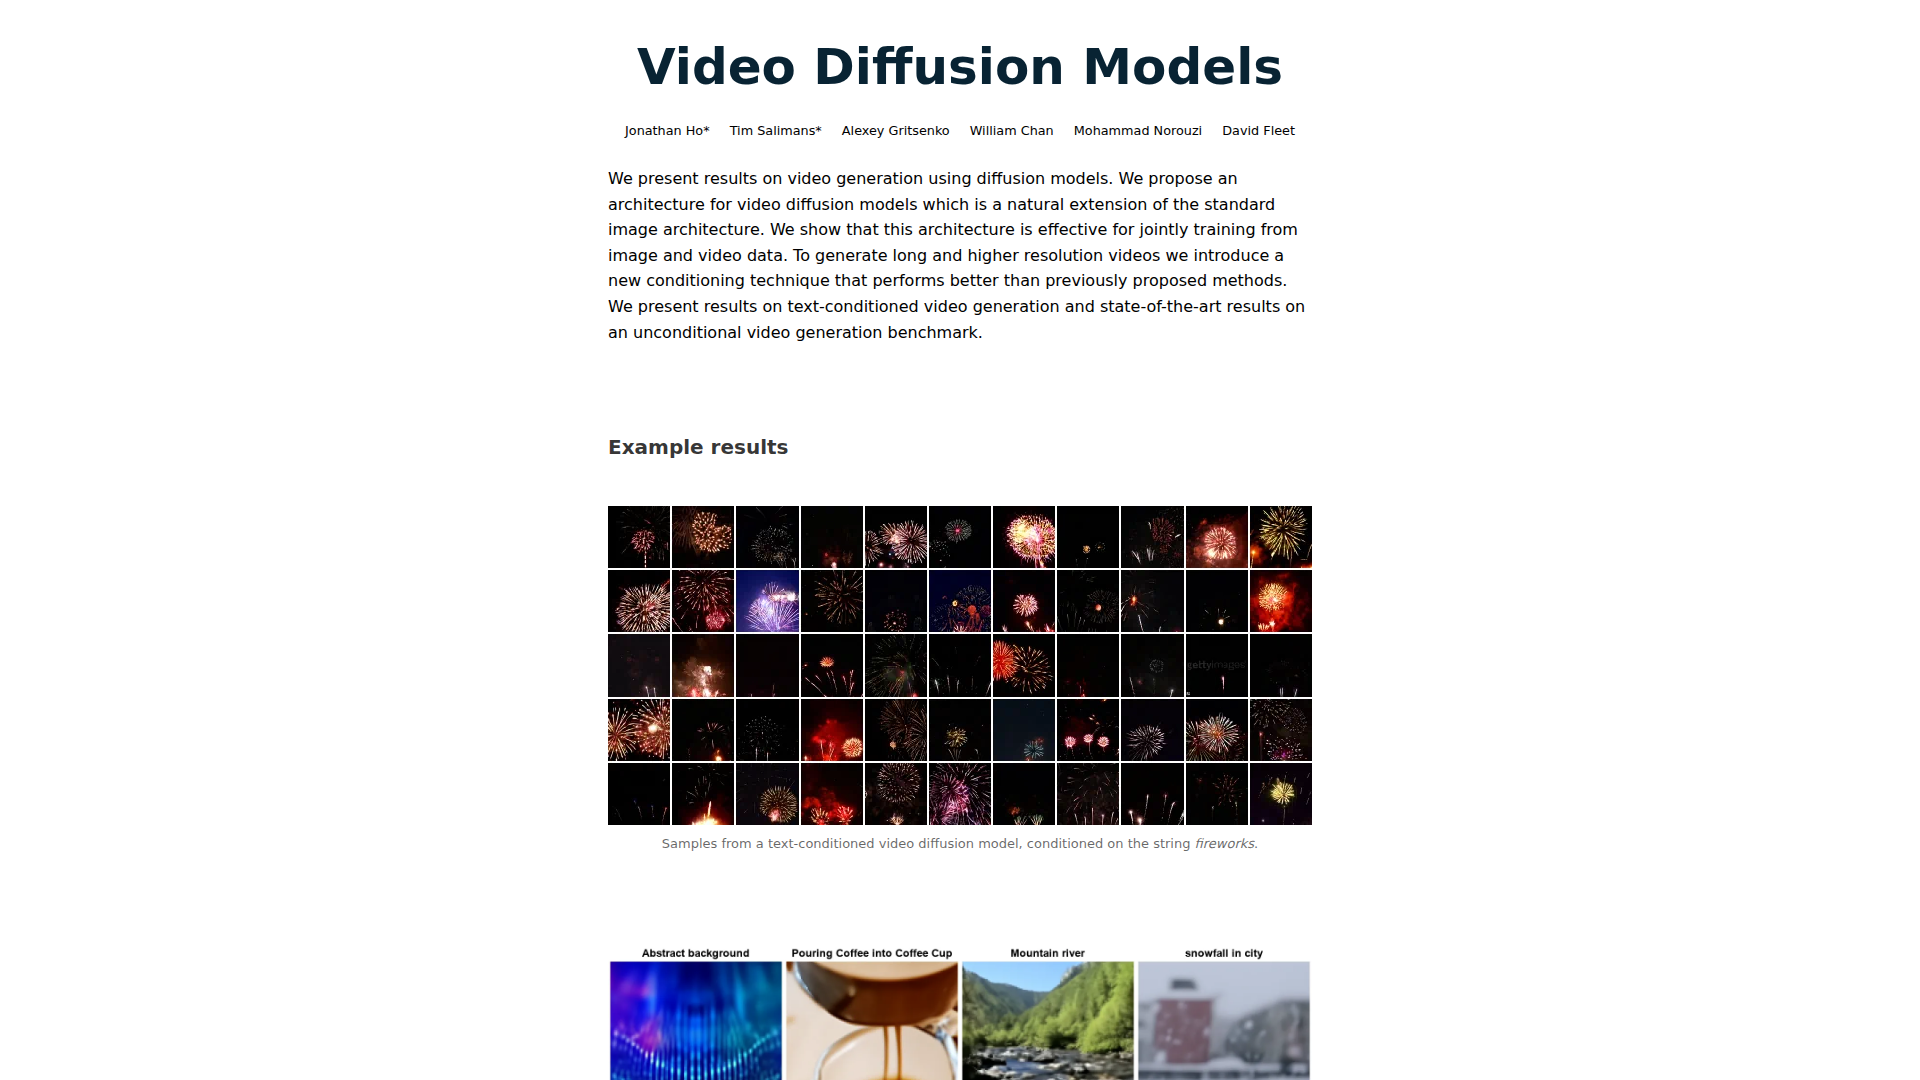
Video Diffusion Models es un sistema de investigación para generar video con modelos de difusión. Está dirigido a investigadores de aprendizaje automático y equipos que trabajan en medios generativos, especialmente aquellos que exploran la generación de video condicionada por texto, la generación de video no condicionada y métodos para extender a video las arquitecturas estándar de difusión de imágenes.
El flujo de trabajo principal consiste en entrenar un modelo de difusión sobre bloques de fotogramas de video de longitud fija, combinar opcionalmente entrenamiento con imágenes y video, y luego extender la generación a videos más largos o de mayor resolución mediante un método de condicionamiento durante el muestreo. Según el contenido de la página, esto se entiende mejor como un enfoque de investigación y una arquitectura de modelo, más que como un producto empaquetado para usuarios finales.
Funcionalidades
- Generación de video con modelos de difusión: Aplica modelado de difusión gaussiana al video, mostrando que es posible producir video de alta calidad con cambios relativamente limitados respecto a configuraciones estándar de difusión de imágenes.
- Arquitectura UNet espacio-temporal factorizada: Extiende la UNet 2D común de imágenes al video de una forma diseñada para manejar datos espaciotemporales dentro de las restricciones de memoria de los aceleradores.
- Entrenamiento conjunto de imágenes y video: Permite entrenar con objetivos tanto de imagen como de video, lo que, según los autores, es importante para mejorar la calidad de las muestras de video.
- Generación de video condicionada por texto: Genera videos a partir de prompts de texto, con ejemplos mostrados de resultados condicionados por prompt.
- Extensión autorregresiva para videos más largos: Reutiliza un modelo entrenado con bloques fijos para generar videos más allá de su ventana nativa de fotogramas operando de forma autorregresiva por bloques sobre los fotogramas.
- Método de condicionamiento basado en gradientes: Mejora la consistencia con la información de condicionamiento durante el muestreo y se presenta como superior a métodos previos de tipo reemplazo para la coherencia temporal y la extensión a mayor resolución.
Consejos útiles
- Trátalo como una base de investigación, no como una plataforma lista para usar: La página presenta métodos y resultados, pero no describe herramientas de despliegue, APIs ni controles de producción.
- Verifica el encaje con tu caso de uso: La evidencia más sólida aquí es para investigación en video generativo, especialmente en benchmarks no condicionados y generación condicionada por texto, más que para edición, producción comercial de activos o gestión de flujos de trabajo empresariales.
- Evalúa cuidadosamente la consistencia temporal: En sistemas de video, la coherencia entre fotogramas importa tanto como la calidad de cada fotograma, y este trabajo enfatiza específicamente métodos de condicionamiento que mejoran esa propiedad.
- Considera estrategias mixtas de entrenamiento con imágenes y video: Si vas a reproducir o adaptar este enfoque, el beneficio reportado del entrenamiento conjunto de imágenes y video puede ser importante cuando los datos de solo video son limitados o ruidosos.
- Revisa el artículo completo antes de implementar: La página es un resumen, por lo que los detalles prácticos sobre configuración de entrenamiento, limitaciones y benchmarking probablemente requieran consultar el artículo citado.
Habilidades de OpenClaw
Dentro del ecosistema OpenClaw, este trabajo probablemente serviría como un bloque de construcción centrado en el modelo para flujos de trabajo de video generativo, más que como una aplicación de negocio independiente. Las capacidades probables podrían incluir agentes de experimentación de prompt a video, flujos de trabajo de evaluación de benchmarks, canalizaciones de preparación de datos para entrenamiento conjunto de imágenes y video, y copilotos de investigación que comparen estrategias de muestreo, coherencia temporal y comportamiento del condicionamiento entre ejecuciones. Estos son casos de uso inferidos; la página no indica ninguna integración nativa con OpenClaw.
Para equipos de I+D en medios, laboratorios de IA o empresas de herramientas creativas, una capa basada en OpenClaw sobre este modelo podría transformar el trabajo al hacer que la generación de video sea más operativa y evaluable. Los agentes probables podrían automatizar barridos de prompts, ejecutar revisiones de calidad sobre clips generados, gestionar trabajos de generación de video largo autorregresiva por bloques y resumir hallazgos experimentales para investigadores o equipos de producto. En la práctica, eso convertiría el modelo de un resultado de investigación en un componente de flujo de trabajo repetible para prototipado y evaluación en canalizaciones de video generativo.
Código de inserción
Comparte esta herramienta de IA en tu sitio o blog copiando y pegando el código. El widget insertado se actualizará automáticamente con la información más reciente.
<iframe src="https://aimyflow.com/ai/video-diffusion-github-io/embed" width="100%" height="400" frameborder="0"></iframe>
Explorar herramientas similares
Editor de fotos con IA gratis: edita y genera imágenes en línea | Pokecut
Pokecut es un editor de fotos con IA para quitar fondos, mejorar imágenes y generar visuales online, ideal para vendedores ecommerce, marketers y creadores. Acelera la producción de imágenes listas para diseño con menos edición manual.
Roboflow: Herramientas de visión por computadora para desarrolladores y empresas
Roboflow es una plataforma de visión por computadora que ayuda a desarrolladores, ingenieros de aprendizaje automático y empresas a anotar datos, entrenar modelos, crear flujos de trabajo y desplegar IA de visión para imágenes, video y transmisiones en tiempo real. En operaciones impulsadas por IA, puede ayudar a los equipos de visión por computadora y ML a pasar más rápido del prototipo a producción al combinar el etiquetado de datos, el entrenamiento de modelos y el despliegue en un solo flujo de trabajo.
Seedance 2.0
Seedance 2.0 es el modelo de generación de video con IA de ByteDance, diseñado para crear videos de alta calidad desde prompts e inputs multimodales, ideal para creadores, desarrolladores y equipos de medios. En la era de la IA, convierte ideas en recursos visuales listos para producción con mucha menos edición manual.
Struct | Automatiza tu runbook de guardia
Struct es un agente de guardia con IA que investiga alertas y errores de ingeniería analizando logs, métricas, trazas y bases de código, ideal para ingenieros de software y equipos SRE. En la era de la IA, reduce el tiempo de triage al entregar hallazgos de causa raíz y posibles soluciones dentro del flujo de trabajo.
GitMind Chat - Tu mejor asistente de IA
GitMind Chat es una plataforma de asistente de IA y chatbot que ayuda a individuos y empresas a gestionar conversaciones, análisis, redacción, programación, traducción, servicio al cliente y creación de agentes de IA personalizados mediante asistentes predefinidos o configurables. Para perfiles como especialistas en marketing, analistas, equipos de soporte, educadores y desarrolladores, puede optimizar el trabajo repetitivo basado en el conocimiento al combinar chat, entradas de archivos y enlaces, análisis de imágenes y respuestas contextuales en un solo flujo de trabajo.
Creador de sitios web con IA de GitPage | GitPage
GitPage es un creador de sitios web con IA que genera y despliega sitios web, tiendas en línea y páginas de destino a partir de un formulario, principalmente para freelancers, agencias, startups y empresas que buscan crear sitios sin código con propiedad del código. Para profesionales web y equipos de atención a clientes, puede reducir la configuración manual y la redacción de contenido al automatizar la generación de páginas, el contenido del blog y el despliegue en GitHub o GitLab Pages.
Rohan Mehta
Rohan Mehta es un sitio web personal de un ingeniero de software con sede en Nueva York en OpenAI, que describe su trayectoria en Meta y como fundador de una startup respaldada por YC, y destaca su rol de creador detrás de la app de tránsito Subway Time NYC. Para ingenieros de software y equipos técnicos de contratación, este tipo de perfil conciso ayuda a la evaluación de talento en la era de la IA al mostrar rápidamente experiencia relevante en desarrollo, escalado y producto.
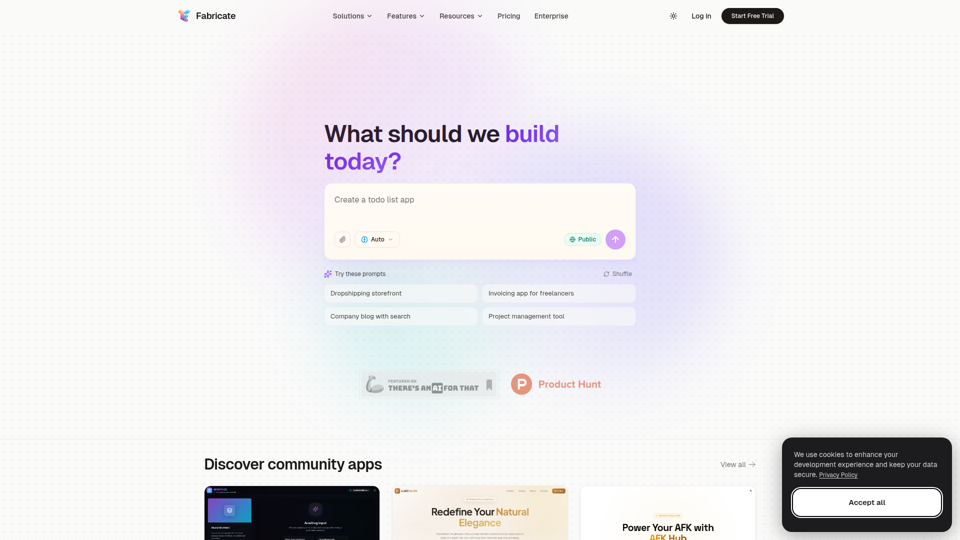
Fabricate - Creador de aplicaciones full-stack con IA | Crea cualquier cosa, lanza más rápido
Fabricate es un creador de aplicaciones full-stack con IA que ayuda a los usuarios a describir una idea de aplicación y generar aplicaciones web listas para producción, principalmente para fundadores, desarrolladores, diseñadores, freelancers, agencias y empresas. En el desarrollo de productos asistido por IA, puede ayudar a estos equipos a avanzar más rápido desde el concepto hasta código desplegable en React, TypeScript y backend, con menos configuración manual.