
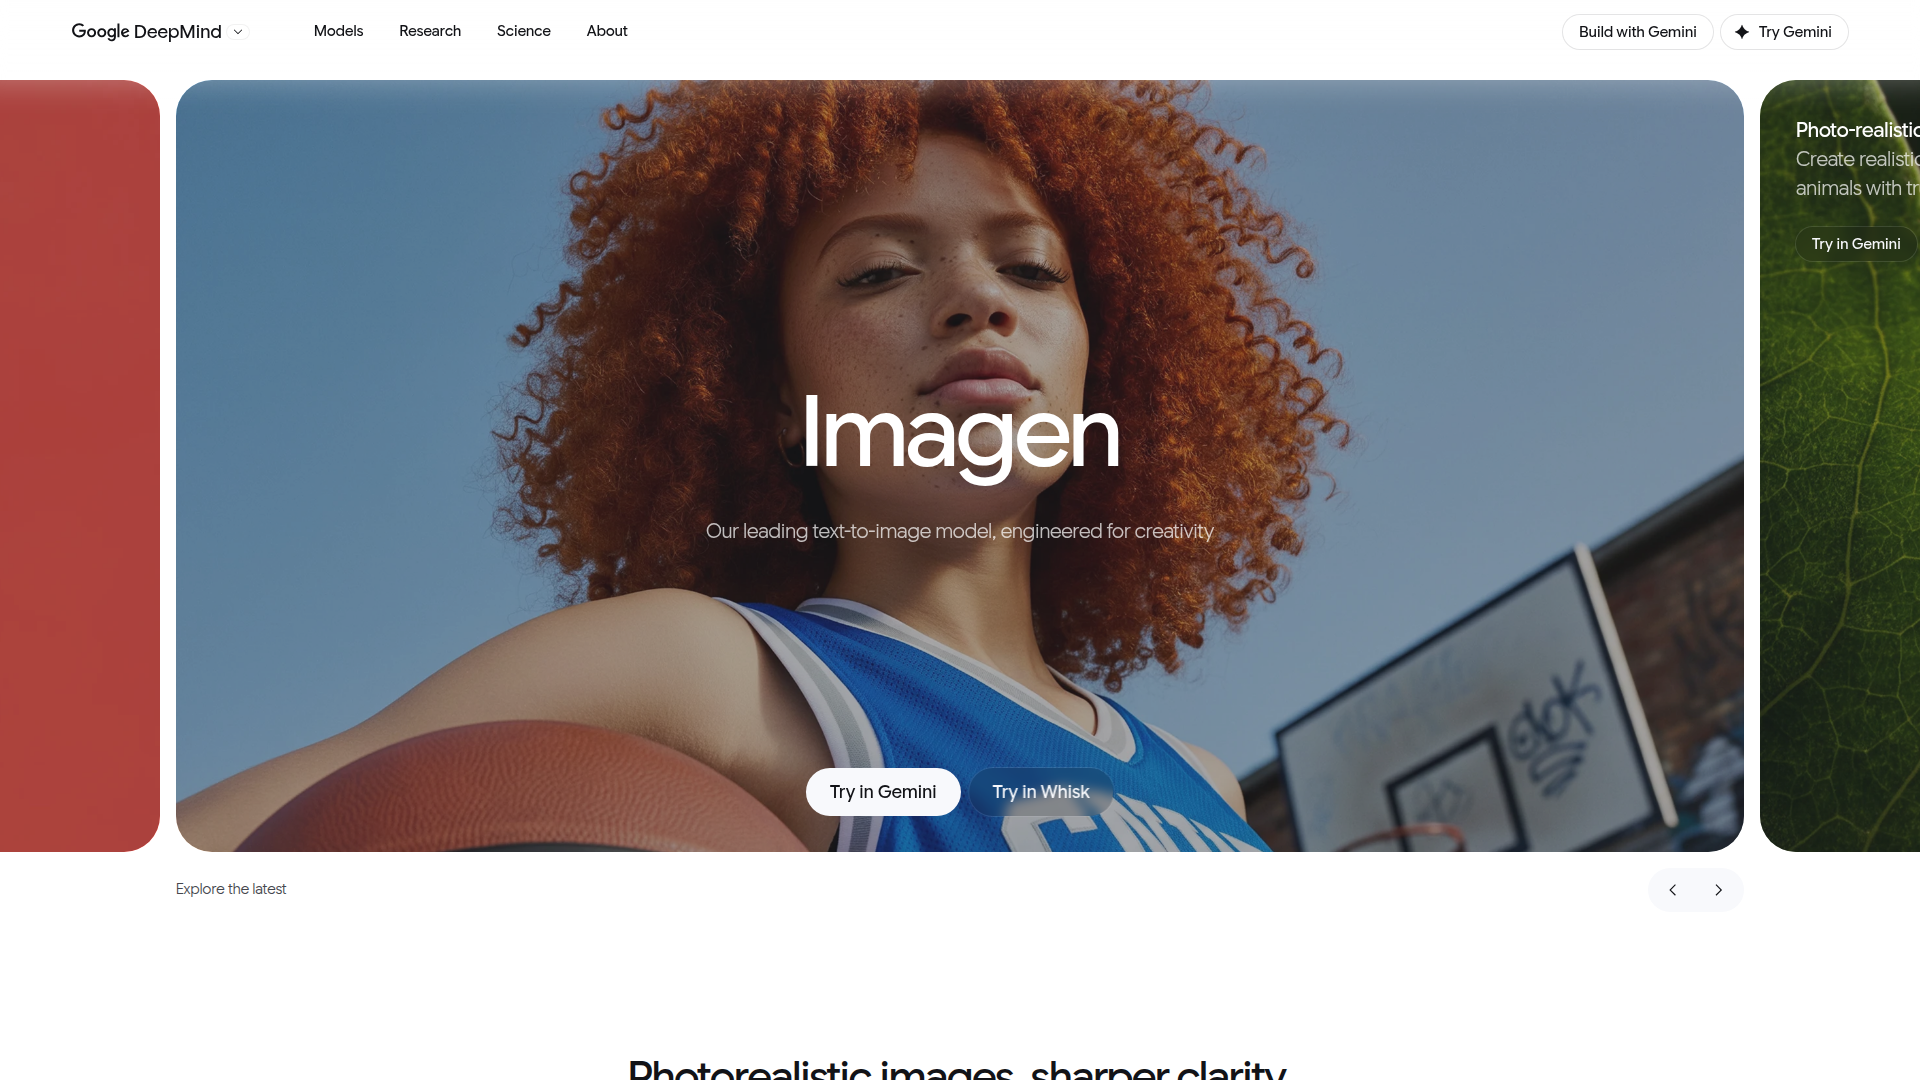
Imagen — Google DeepMind
Valora esta herramienta
Puntuación media
Votos totales
Selecciona tu puntuación (1-10):
Información detallada
Qué
Imagen es el modelo de texto a imagen de Google DeepMind para generar imágenes de alta calidad a partir de instrucciones escritas. La página presenta Imagen 4 como la versión más reciente, posicionada como un modelo líder para la generación creativa de imágenes, con mejoras en fotorrealismo, claridad, ortografía, tipografía y renderizado en múltiples estilos visuales.
Parece adecuado para usuarios que necesitan una generación rápida de conceptos o resultados visuales pulidos, como equipos creativos, diseñadores, especialistas en marketing y desarrolladores que trabajan con herramientas relacionadas con Gemini. Según la página, el flujo de trabajo principal se basa en la creación de imágenes mediante prompts, con opciones para probarlo en Gemini y Whisk, aunque la página no describe por completo flujos de producción más amplios, opciones de implementación ni controles empresariales.
Funciones
- Generación de texto a imagen — Convierte instrucciones escritas en imágenes de alta calidad, lo que lo hace útil para la ideación visual rápida y la creación de contenido.
- Renderizado fotorrealista — Produce imágenes realistas de paisajes, plantas, personas y animales con detalles fieles a la realidad para lograr resultados creativos más naturales.
- Generación de detalles finos — Capta primeros planos con colores, texturas y degradados más ricos, lo que resulta valioso para imágenes visualmente densas o con apariencia táctil.
- Compatibilidad con estilos artísticos diversos — Renderiza estilos que van desde el fotorrealismo hasta el impresionismo, el abstracto y la ilustración, ayudando a los equipos a explorar múltiples direcciones creativas desde un solo flujo de trabajo basado en prompts.
- Mejor renderizado de texto — La página destaca una ortografía y tipografía más sólidas, lo que puede reducir problemas comunes de generación de imágenes cuando los elementos visuales incluyen texto.
- Opciones de velocidad y resolución — Incluye un modo ultrarrápido descrito como hasta 10 veces más rápido que el modelo anterior y admite resultados de hasta 2k de resolución para iteraciones más rápidas y activos finales más claros.
Consejos útiles
- Valide la tipografía en casos de uso reales — Incluso con mejoras en ortografía y renderizado de texto, los modelos de imagen deben seguir revisándose cuidadosamente cuando los resultados contienen nombres de marca, etiquetas o texto denso.
- Adapte el estilo del prompt al tipo de resultado — Es probable que los prompts detallados importen más para trabajos fotorrealistas y de primer plano, mientras que los prompts orientados al estilo pueden ser más eficaces para ilustración o conceptos abstractos.
- Use modos rápidos para explorar y luego refine — Un modo de generación más rápido es muy adecuado para probar conceptos, pero los resultados de mayor claridad pueden reservarse mejor para las ideas preseleccionadas.
- Evalúe la consistencia del estilo antes de una implementación más amplia — Si un equipo planea usar Imagen para campañas o producción creativa recurrente, conviene probar con qué consistencia reproduce tono, texturas y composición entre distintos prompts.
- Aclare pronto el acceso a la herramienta y la gobernanza — La página muestra disponibilidad a través de Gemini y Whisk, pero no detalla controles administrativos, gestión de derechos de los activos ni administración del flujo de trabajo, por lo que los compradores deben confirmarlo por separado.
Habilidades de OpenClaw
Imagen podría encajar bien en el ecosistema de OpenClaw como un componente de generación visual dentro de flujos de trabajo más amplios de contenido, campañas o diseño. Un caso de uso probable sería un agente de OpenClaw que convierta un brief creativo en prompts estructurados, genere múltiples direcciones de imagen mediante Imagen, evalúe los resultados según las directrices de marca y dirija los activos seleccionados a etapas de revisión para equipos de marketing o diseño. La página respalda la creación de imágenes basada en prompts, pero no confirma una integración nativa con OpenClaw, por lo que esto debe tratarse como una inferencia de flujo de trabajo.
Las habilidades de OpenClaw basadas en Imagen podrían incluir generación de prompts seguros para la marca, exploración de conceptos de campaña, ideación de escenas de producto, soporte para ilustración editorial y pruebas automatizadas de variaciones para distintas audiencias o canales. En las operaciones creativas, esta combinación podría llevar a los equipos desde la elaboración manual de activos hacia canales visuales orquestados en los que los agentes ayuden a traducir briefs en opciones de imagen, comparar la fidelidad de estilo y preparar activos para su publicación o experimentación posterior.
Código de inserción
Comparte esta herramienta de IA en tu sitio o blog copiando y pegando el código. El widget insertado se actualizará automáticamente con la información más reciente.
<iframe src="https://aimyflow.com/ai/deepmind-google-technologies-imagen-3/embed" width="100%" height="400" frameborder="0"></iframe>
Explorar herramientas similares
Versive
Versive es una plataforma de investigación y pruebas de usuarios impulsada por IA que ayuda a los equipos de producto a diseñar, ejecutar y sintetizar estudios de usabilidad con usuarios reales y simulados, especialmente para gerentes de producto, investigadores de UX y diseñadores. En el desarrollo de productos asistido por IA, puede ayudar a estos equipos a validar decisiones de interfaz más rápidamente al generar transcripciones, capturas de pantalla, resúmenes y recomendaciones accionables en cuestión de minutos.
Desafíos | Pon a prueba tus habilidades para crear prompts de IA
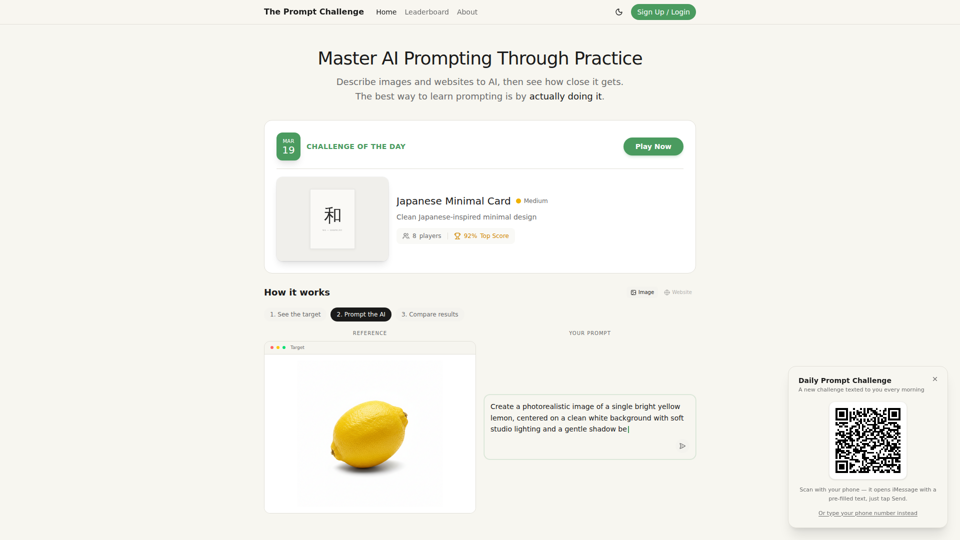
Prompt Challenge es una plataforma de práctica que ayuda a los usuarios a mejorar la creación de prompts para IA describiendo imágenes y sitios web, comparando los resultados generados por IA con referencias y compitiendo por puntuaciones, principalmente para personas que están aprendiendo ingeniería de prompts y creación práctica con IA. Para diseñadores, desarrolladores y profesionales de la IA, este tipo de prueba repetible de prompts puede perfeccionar las habilidades para redactar instrucciones y mejorar la consistencia al usar herramientas generativas para trabajos visuales y de interfaz.
Generador de infografías con IA
GraphicInfo es un generador de infografías con IA que ayuda a los usuarios a convertir ideas y contenido en infografías profesionales y personalizables rápidamente, principalmente para creadores y personas que producen contenido para sitios web o redes sociales. En los flujos de trabajo de contenido impulsados por IA, puede ayudar a especialistas en marketing, equipos de contenido y diseñadores a acelerar la creación de recursos visuales mientras siguen perfeccionando textos e imágenes para necesidades específicas de marca.
Desenfocar imagen — Haz que las fotos borrosas sean nítidas con IA
Unblur Image es una herramienta en línea de eliminación de desenfoque fotográfico impulsada por IA que ayuda a los usuarios a corregir el desenfoque por movimiento, enfocar imágenes fuera de foco, restaurar fotos antiguas y mejorar la claridad del texto, principalmente para personas que necesitan una mejora rápida de imágenes sin conocimientos de edición manual. En los flujos de trabajo de la era de la IA, puede ayudar a fotógrafos, equipos de contenido y profesionales que trabajan intensivamente con documentos a recuperar visuales utilizables y recursos legibles más rápido a partir de imágenes de origen imperfectas.
IconBrain | Generador de iconos con IA para apps y marcas
IconBrain es un generador de íconos, banners y activos de marca con IA que ayuda a los usuarios a crear y editar elementos visuales listos para producción a partir de indicaciones de texto o del contexto de marca, principalmente para desarrolladores y creadores que lanzan aplicaciones o marcas. Para trabajo de producto, marketing y diseño, puede acelerar la creación temprana de activos de marca mientras ayuda a los equipos a mantener estilos visuales más consistentes en todas las plataformas.
Generador gratuito de imágenes a prompts - image2prompt.net
image2prompt.net es un generador gratuito de imagen a prompt con IA que analiza imágenes cargadas o URL de imágenes y las convierte en prompts editables para Midjourney, Stable Diffusion, Flux y modelos similares, principalmente para artistas, diseñadores y creadores de IA. Para los profesionales creativos, puede acelerar la redacción de prompts, favorecer la coherencia de estilo y reducir la reescritura manual de prompts en distintos flujos de trabajo de generación de imágenes.
UXCanvas.ai | Agente de diseño UI/UX con IA — Descríbelo, diséñalo
UXCanvas.ai es un agente de diseño UI/UX con IA que ayuda a los usuarios a convertir indicaciones de texto en diseños de interfaces listos para producción, iterar mediante chat y exportar a Figma o código React, principalmente para diseñadores y desarrolladores. Para equipos de UI/UX y de producto, puede acortar el camino desde el concepto hasta la entrega al convertir ideas preliminares en especificaciones estructuradas, componentes reutilizables y recursos listos para código.
IA HD Anime: Tu mejor opción para mejorar la resolución de imágenes de anime
AI HD Anime es una herramienta gratuita en línea de escalado de imágenes con IA que mejora imágenes de anime y manga con mayor claridad y detalle restaurado, principalmente para los fans del anime. En flujos de trabajo creativos y de archivo asistidos por IA, puede ayudar a ilustradores, editores y curadores de comunidades a mejorar rápidamente imágenes de anime de baja resolución para su revisión, difusión o preservación.